

Durante más de una década, la atribución digital se apoyó en la siguiente premisa: si podíamos seguir a cada usuario clic a clic, podíamos saber exactamente qué campaña generaba cada venta. Esa premisa se ha roto. No de golpe, sino por acumulación de bloqueos de navegador, normativa de privacidad, jardines vallados y usuarios que rechazan el banner de cookies.
El resultado es un agujero silencioso en los informes, campañas que parecen no funcionar porque su impacto no se registra, y canales que se llevan el mérito de conversiones que no han generado. Frente a ese escenario, muchos equipos de marketing están recuperando una técnica que llevaba décadas funcionando en gran consumo y que hoy vive una segunda juventud: el Marketing Mix Modeling.
¿Qué es Marketing Mix Modeling?
El Marketing Mix Modeling (MMM) es una técnica de modelado estadístico que estima la relación entre las variables de marketing de una empresa y sus resultados de negocio, normalmente ventas o ingresos.
En lugar de seguir el recorrido de cada usuario, el MMM trabaja con datos agregados a lo largo del tiempo. Toma series históricas (habitualmente semanales) de inversión por canal, ventas, precios, promociones, distribución, estacionalidad y factores externos, y calcula cuánto ha aportado cada variable al resultado final.
La forma más simple del modelo es una regresión del tipo:
Ventas = base + (efecto de TV) + (efecto de Search) + (efecto de Social) + (efecto del precio) + (estacionalidad) + otros factores
A partir de ahí, un modelo real incorpora transformaciones que reflejan cómo funciona de verdad la publicidad, ya que los efectos que se arrastran en el tiempo, rendimientos decrecientes y variables que nada tienen que ver con los medios.
La diferencia con la atribución tradicional es conceptual. Los modelos de atribución reparten el mérito de una conversión ya ocurrida entre los puntos de contacto que la precedieron. El MMM responde a otra pregunta: qué habría pasado si esa inversión no hubiera existido. Es decir, mide incrementalidad, no reparto.
¿Por qué el fin del rastreo individual ha revivido el MMM?
Conviene precisar algo que se repite mal en muchos artículos, las cookies de terceros no han desaparecido de los navegadores. En abril de 2025, Google dio marcha atrás en su plan de eliminación y, en octubre de ese mismo año, retiró la mayor parte de las APIs de Privacy Sandbox (Chavez, 2025). El escenario no es el apocalipsis anunciado, pero tampoco es el de 2018.
Lo que sí ha ocurrido es una erosión progresiva de la medición determinista:
- Safari bloquea cookies de terceros por defecto desde 2020 (Wilander, 2020), Firefox las particiona desde 2022 (Mozilla, 2022) y Brave las bloquea de serie. En conjunto, en torno a un 20% del tráfico global navega ya con bloqueo o partición por defecto, con porcentajes muy superiores en móvil.
- El consentimiento filtra otra parte del tráfico. Las tasas de aceptación varían enormemente según el diseño del banner y el sector, y aunque el Consent Mode V2 permite modelar parte de lo perdido, sigue siendo una estimación sobre una señal incompleta.
- Los jardines vallados no comparten datos a nivel de usuario. Meta, TikTok, Amazon o YouTube reportan sus propias conversiones con sus propias ventanas de atribución, lo que provoca duplicidades imposibles de conciliar.
- La inversión offline nunca ha estado en el embudo digital. Televisión, radio, exterior, patrocinios o notoriedad de marca no dejan clic, y aunque existen técnicas para medir conversiones offline, no cubren el efecto de la publicidad de marca.
El MMM es resistente a todo lo anterior porque no necesita identificar a nadie. Trabaja con agregados: cuánto se invirtió, cuándo y qué pasó con las ventas. Por eso no le afecta el consentimiento, ni el navegador, ni el sistema operativo, ni el bloqueo de identificadores.
Lo que el MMM ve y la atribución digital no
Un modelo bien construido cuantifica el efecto de la televisión sobre las búsquedas de marca, el impacto de una subida de precio, el peso real de la estacionalidad y, sobre todo, qué parte de las ventas se produciría igualmente sin publicidad. Ese último punto suele ser el más incómodo y el más rentable porque en muchos proyectos, una porción relevante de las conversiones atribuidas a retargeting o a campañas de marca habría llegado de todos modos.
Cómo funciona por dentro: adstock, saturación y variables base
Tres conceptos explican por qué un MMM es algo más que una regresión.
Efecto arrastre (adstock)
La publicidad no agota su efecto el día que se emite. Un impacto de hoy puede influir en una compra dentro de tres semanas. El adstock, formulado por Simon Broadbent en 1979, modela esa memoria decreciente, es decir, el efecto de la inversión se reparte en el tiempo y se va desvaneciendo a un ritmo que el modelo estima para cada canal. La televisión suele tener un arrastre largo; la búsqueda de pago, uno muy corto.
Rendimientos decrecientes y saturación
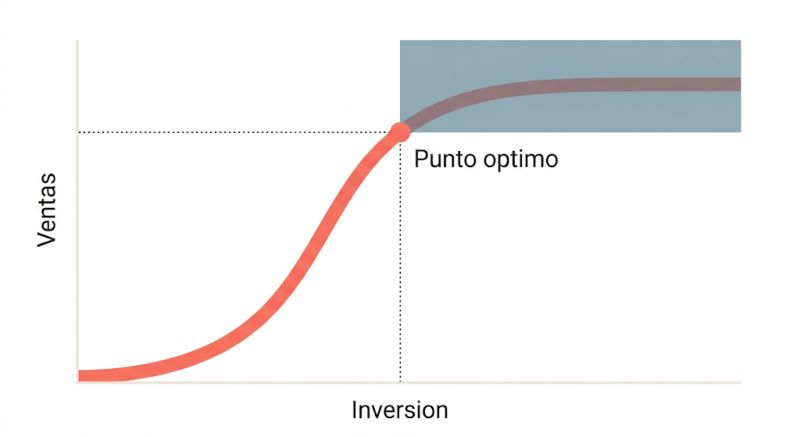
El primer euro invertido en un canal rinde más que el euro número cien mil. Las curvas de respuesta (habitualmente en forma de S o cóncavas) capturan ese punto en el que seguir invirtiendo deja de compensar. Este output es, en la práctica, el más accionable de todo el proyecto: indica dónde estás por debajo del punto óptimo y dónde estás quemando presupuesto sin mover el coste por adquisición.
Variables base y externas
Un modelo honesto separa lo que aporta el marketing de lo que aporta el contexto. Precio, promociones, distribución, actividad de la competencia, clima, calendario, inflación o eventos puntuales entran como variables de control. Sin ellas, el modelo atribuye a la publicidad ciertas subidas que en realidad venían de una promoción agresiva o de la campaña de Navidad.
¿Qué necesitas para lanzar proyectos de Marketing Mix Modeling?
Los proyectos de Marketing Mix Modeling fracasan más por datos que por matemáticas. Antes de plantear un modelo, revisa estos requisitos:
- Histórico suficiente. Como referencia práctica, dos o tres años de datos semanales (entre 100 y 150 observaciones) permiten estimar estacionalidad y efectos de arrastre con cierta solidez. Con un año escaso, el modelo tendrá más parámetros que información.
- Variación en la inversión. Si has invertido exactamente lo mismo en cada canal todas las semanas, el modelo no tiene de dónde aprender. Los cambios de presupuesto, las pausas y los picos de campaña son la materia prima.
- Datos completos de coste, no solo de resultado. Inversión bruta por canal y semana, incluyendo offline y promociones. Aquí una nomenclatura UTM bien definida ahorra semanas de reconstrucción manual.
- Una única fuente de verdad para las ventas. Idealmente del ERP o del backend, no de la plataforma publicitaria. Si el dato viene de Google Analytics 4, conviene contrastarlo antes con la facturación real.
- Registro de eventos del negocio. Roturas de stock, cambios de precio, aperturas de tienda, incidencias logísticas o crisis de reputación. Lo que no documentas, el modelo lo interpreta como ruido o se lo asigna a un canal.
- Un plan de validación. Un MMM sin contraste con experimentos reales es una opinión con decimales.
Un primer proyecto realista lleva entre seis y doce semanas: recopilación y limpieza de datos, construcción del modelo, validación y traducción a escenarios de reparto presupuestario.
Herramientas de marketing mix modeling: open source frente a SaaS
Elegir herramientas de marketing mix modeling depende sobre todo de si tienes o no perfil de data science en el equipo.
Google Meridian
Google Marketing Mix Modeling tiene hoy nombre propio: Meridian, el framework que Google abrió a todo el mundo el 29 de enero de 2025 (Nair, 2025) como sucesor de LightweightMMM. Trabaja con inferencia causal bayesiana, lo que permite incorporar conocimiento previo (por ejemplo, resultados de tests de incrementalidad anteriores) para orientar la estimación en lugar de dejar que el modelo decida solo con datos históricos.
Sus puntos fuertes: integra métricas de alcance y frecuencia, permite incluir el volumen de búsquedas de marca como variable intermedia y está pensado para conectar con los datos de medios de Google. Es código abierto, en Python, y requiere un equipo capaz de mantenerlo.
Meta Robyn y PyMC-Marketing
Robyn, el paquete de código abierto de Meta Marketing Science, está escrito en R y automatiza buena parte del proceso mediante optimización evolutiva, reduciendo el sesgo humano en la selección del modelo. PyMC-Marketing es la alternativa bayesiana en Python, muy flexible y con una comunidad activa.
Las tres opciones tienen el mismo requisito: alguien que sepa modelar. El coste no está en la licencia, está en el talento.
Soluciones de Marketing Mix Model SaaS
La categoría de Marketing Mix Model SaaS ha crecido con fuerza precisamente para cubrir ese hueco. Estas plataformas automatizan la ingesta de datos desde las plataformas publicitarias, ejecutan el modelo con una cadencia semanal o mensual y presentan los resultados en un panel con simuladores de presupuesto, en la línea de lo que ya haces con Data Studio, pero con la capa de modelado incluida.
Entre sus ventajas destacan tiempo de puesta en marcha corto, mantenimiento incluido y una visualización comprensible para dirección. En contra: menos transparencia sobre las decisiones de modelado, dependencia del proveedor y un coste recurrente que conviene comparar con el de mantener el modelo en casa.
Si el MMM va a ser una herramienta de decisión continua y no tienes equipo de datos, el SaaS sale a cuenta. Si necesitas control total sobre supuestos y variables, o tienes un caso de negocio poco estándar, el open source compensa.
Marketing Mix Modeling e IA: ¿qué cambia realmente?
El marketing mix modeling con IA se ha convertido en un reclamo comercial, así que conviene separar lo sustancial del envoltorio. Lo que sí está aportando el aprendizaje automático a esta disciplina:
- Automatización de la selección de modelos. Explorar miles de combinaciones de adstock, saturación y variables de control en horas, no en semanas.
- Métodos bayesianos jerárquicos. Permiten modelar varias regiones, productos o marcas a la vez, compartiendo información entre ellas, algo especialmente útil cuando el histórico de cada unidad es corto.
- Cadencia continua. Los modelos antiguos se entregaban una o dos veces al año en un informe. Los actuales se recalculan de forma regular y alimentan decisiones de presupuesto casi en tiempo de campaña.
- Simulación de escenarios. Optimizadores que proponen un reparto de inversión sujeto a restricciones reales: mínimos por canal, compromisos con medios y límites de saturación.
Es la misma lógica que ya está transformando la gestión de campañas, como ocurre con la automatización de Google Ads mediante IA. Y con la misma advertencia, ya que la IA no resuelve datos malos, histórico corto ni ausencia de experimentos con los que validar. Ningún modelo, por sofisticado que sea, distingue causalidad de coincidencia si nunca has variado la inversión.
Triangulación: MMM, atribución y experimentos
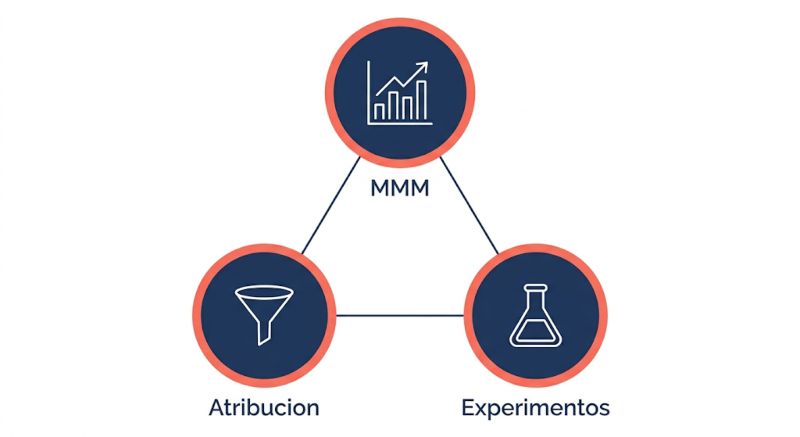
El error más común es plantear el MMM como sustituto de todo lo demás. Funciona mucho mejor como una de las tres patas de un sistema de medición:
- MMM para decidir el reparto estratégico del presupuesto entre canales, incluyendo offline y marca. Visión de medio plazo.
- Atribución digital y datos de plataforma para la optimización táctica del día a día: creatividades, audiencias, pujas. Aquí una implementación sólida, con medición en servidor cuando el caso lo justifica, marca la diferencia en la calidad del dato.
- Experimentos de incrementalidad (geo tests, tests de encendido y apagado, holdouts) para obtener lecturas causales limpias que sirvan además para calibrar el MMM.
Cuando las tres fuentes coinciden, la decisión es sólida. Cuando divergen, la discrepancia suele señalar exactamente dónde está el problema de medición.
Limitaciones que conviene asumir
Los puntos débiles del MMM son conocidos por no servir para optimización granular (no te dirá qué anuncio pausar mañana), necesita histórico suficiente, tiene dificultades para separar canales que suben y bajan siempre a la vez, y exige gobierno del dato. Si cada mes cambia la forma de contabilizar la inversión, el modelo se vuelve inservible. Añade además que un ROI estimado sin su margen de error es una cifra incompleta, puesto que los intervalos de confianza forman parte del resultado.
Cómo empezar sin sobredimensionar el proyecto
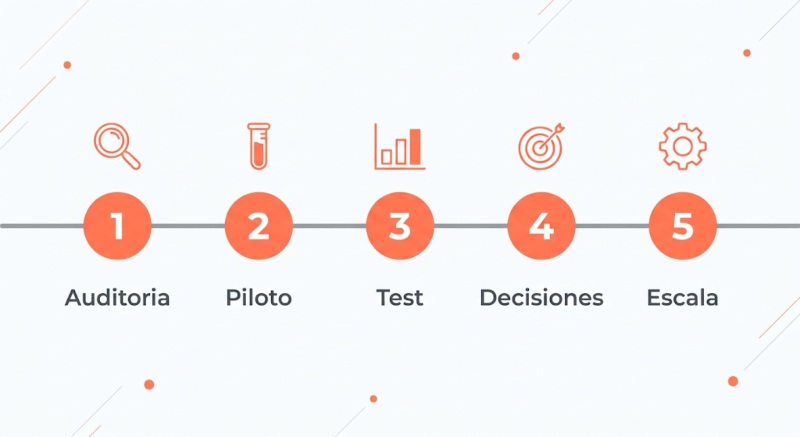
Una hoja de ruta razonable para una empresa que parte de cero:
- Auditoría de datos. Reconstruir el histórico de inversión y ventas, semana a semana, y detectar los huecos.
- Modelo piloto sobre un mercado o línea de producto. Un alcance acotado permite validar el enfoque sin comprometer seis meses de trabajo.
- Contraste con un experimento. Un GEO test sobre un canal concreto confirma o desmiente lo que dice el modelo.
- Traducción a decisiones. El entregable útil no es el modelo, son los escenarios de reasignación de presupuesto con su impacto esperado sobre los KPIs del negocio.
- Industrialización. Cadencia fija de actualización, propietario del dato y un panel que la dirección pueda leer sin ayuda.
Empieza por el dato, no por el modelo
El marketing mix modeling no devuelve la ilusión de la trazabilidad perfecta que teníamos hace unos años. Ofrece algo más útil, una estimación defendible de qué aporta cada euro invertido, construida sobre datos que ninguna decisión de navegador ni cambio normativo puede retirar.
Dicho esto, sabemos que empezar con MMM puede resultar abrumador, y no es cuestión de hacerlo solo. El punto de partida no es el modelo, sino el dato, y si quieres ordenar bien esa base antes de dar el siguiente paso, en agenciaSEO.eu contamos con un equipo de analítica web a tu disposición para acompañarte en el proceso.
Preguntas frecuentes sobre el marketing mix modeling
¿Qué diferencia hay entre marketing mix modeling y atribución multitouch?
El MMM trabaja con datos agregados y estima el efecto incremental de cada palanca sobre las ventas totales. La atribución multitouch trabaja a nivel de usuario y reparte el crédito de conversiones ya producidas entre los puntos de contacto. Uno responde a cuánto aporta cada canal; el otro, a cómo se reparte lo ya conseguido.
¿Es válido el MMM para una pyme o solo para grandes anunciantes?
Es viable siempre que exista histórico suficiente y variación de inversión. El límite no es el tamaño de la empresa, sino el volumen y la calidad de los datos. Por debajo de cierta inversión y de dos años de histórico, los experimentos de incrementalidad suelen dar más valor por menos esfuerzo.
¿Con qué frecuencia debe actualizarse el modelo?
Lo habitual hoy es una actualización mensual o trimestral. Las revisiones anuales que se estilaban hace años llegan tarde para influir en la planificación.
¿Necesito eliminar mi medición actual para implantar un MMM?
No. El MMM convive con la analítica digital y la refuerza. De hecho, mantener una buena implementación de medición (consentimiento correctamente configurado, seguimiento en servidor, datos propios) mejora la calidad de las variables que alimentan el modelo.

