

Detrás de cada página web hay elementos que el usuario no ve, pero que son clave para que funcione. Las URLs son uno de ellos porque aparecen en la barra del navegador, pero su papel va mucho más allá de indicar una dirección.
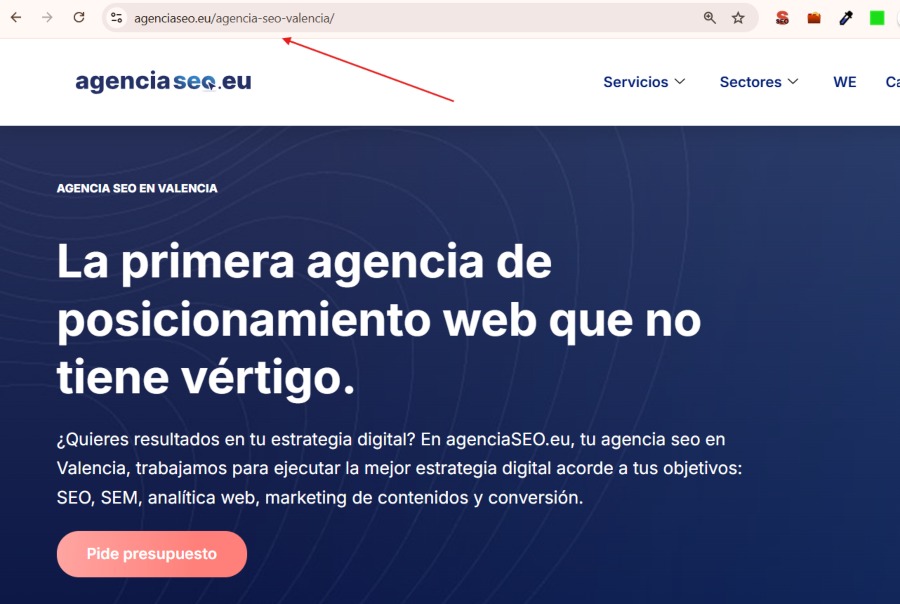
En esta primera captura puedes ver la URL canónica de una de nuestras páginas de servicio: https://agenciaseo.eu/agencia-seo-valencia/
En esta segunda captura aparece la misma página, pero con parámetros añadidos al final de la URL: https://agenciaseo.eu/agencia-seo-valencia/?nocache=1776519984
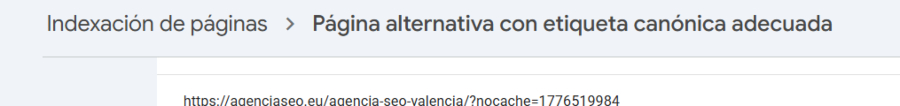
Esa cadena final la añade el plugin de caché. Y no es un caso aislado, ya que cuando publicas una página, la propia web puede generar varias versiones de su URL por distintos motivos.
Si esto pasa con muchas páginas y nadie lo controla, Google puede acabar indexando cientos o miles de URLs sin ningún valor SEO. Cuando ocurre a gran escala, tienes un problema de index bloat.
Y a Google no le gusta nada, porque busca claridad, no ruido. Por eso, en su índice solo deberían estar las páginas que de verdad importan para tu negocio.
👀 Te puede interesar: ¿Cómo saber si una página está indexada en Google?
¿Por qué es un problema para tu SEO?
- Diluye la calidad de tu web. Google no evalúa cada página por separado, sino tu web en su conjunto. Si encuentra mucho contenido duplicado, automático o sin propósito, eso también perjudica a las páginas que sí importan.
- Provoca canibalización. Estas URLs pueden competir con las canónicas por las mismas palabras clave. Google no sabe cuál mostrar, reparte las señales entre ellas y al final ninguna posiciona como debería.
- Gasta presupuesto de rastreo. Si Google tiene que rastrear miles de URLs sin valor, puede tardar más en llegar a las que de verdad te interesan.
Cuidado con el crawl budget solo es un problema real en webs muy grandes, como un ecommerce con miles de productos. Con 400 URLs no tienes de qué preocuparte. Sin embargo, con miles de URLs basura aparece un síntoma claro, que cuando publicas páginas nuevas y tardan semanas en indexarse.
¿Qué otras formas tengo de comprobar si tengo index bloat?
Es probable que tengas index bloat si te pasa alguna de estas cosas:
Causas más habituales
El index bloat casi nunca aparece por una decisión consciente. Lo normal es que se vaya acumulando poco a poco, por funciones que el CMS activa por defecto, por filtros que generan URLs nuevas o por restos técnicos que nadie revisa. Estas son las causas que más nos encontramos en las auditorías:
Los filtros de una tienda online pueden hacer que un mismo producto tenga muchas URLs distintas. Lo verás más claro con un ejemplo.
Imagina una camiseta que se vende en 2 colores (negro y rojo) y en 2 tallas (S y M).
Su URL principal, la única que debería estar en Google, es esta: tiendaderopa.com/camisetas/modelo-x
Pero cada vez que alguien usa un filtro, se crea una URL nueva:
Filtrando por color:
- tiendaderopa.com/camisetas/modelo-x?color=negro
- tiendaderopa.com/camisetas/modelo-x?color=rojo
Filtrando por talla:
- tiendaderopa.com/camisetas/modelo-x?talla=s
- tiendaderopa.com/camisetas/modelo-x?talla=m
Combinando color y talla:
- tiendaderopa.com/camisetas/modelo-x?color=negro&talla=s
- tiendaderopa.com/camisetas/modelo-x?color=negro&talla=m
- tiendaderopa.com/camisetas/modelo-x?color=rojo&talla=s
- tiendaderopa.com/camisetas/modelo-x?color=rojo&talla=m
Resultado: Una sola camiseta genera 9 URLs, y solo una de ellas debería indexarse. Ahora multiplícalo por todos los productos, colores y tallas de una tienda, y entenderás lo rápido que se dispara el problema.
Buscador interno indexado
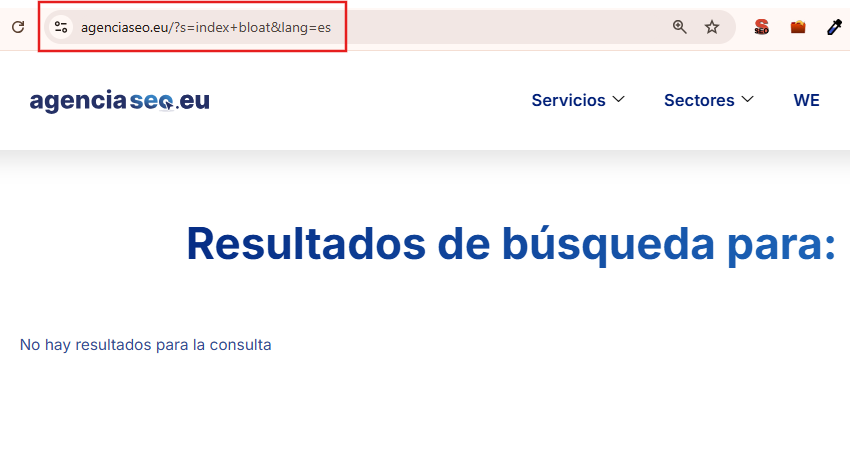
Cada vez que alguien usa el buscador de tu web, se crea una URL nueva con lo que ha buscado. Por ejemplo, si buscas “index bloat” en un WordPress, la URL queda así:
tudominio.com/?s=index+bloat
Si esas páginas se indexan, puedes acabar con cientos de URLs que solo muestran listados de resultados, sin contenido propio y Google hace años que dejó claro que no quiere páginas de resultados de búsqueda dentro de sus propios resultados.
Taxonomías y archivos de WordPress
WordPress crea automáticamente páginas que agrupan contenidos por etiqueta, por autor o por fecha. El problema es que muchas no aportan nada. Por ejemplo, una etiqueta que solo tiene un artículo, o una página de autor en una web donde escribe una sola persona. Suelen venir activadas por defecto y casi nadie las revisa.
Duplicidad de protocolo y parámetros
Una misma página puede tener varias direcciones casi idénticas:
- Con http:// y con https://
- Con www y sin www
- Con barra final (/) y sin ella
- Con parámetros de campañas, como ?utm_source= o ?gclid=
Para ti son la misma página, pero para Google cada una puede ser una URL distinta que indexar.
Restos técnicos
Son páginas que nunca deberían haber llegado a Google, como estas:
- Entornos de pruebas (staging) que se han quedado abiertos al público.
- Páginas de agradecimiento, las que aparecen tras enviar un formulario o hacer una compra.
- Bloques reutilizables del maquetador, que el CMS guarda como URLs aunque no sean páginas reales.
- Contenido generado a escala, cientos de páginas casi iguales en las que solo cambia un dato, como el nombre de una ciudad.
Cómo detectarlo
Puedes comprobarlo en tres pasos, de más rápido a más preciso:
- La prueba rápida con Google. Escribe site:tudominio.com en el buscador y compara el número de resultados con las páginas que crees tener. Si Google muestra diez veces más, algo pasa. Eso sí, esta cifra es aproximada y sirve como primera pista, no como diagnóstico.
- El informe de indexación de Search Console. Entra en Indexación → Páginas y fíjate en dos estados:
- Rastreada: actualmente sin indexar. Google ha visitado esas URLs y ha decidido que no merecen estar en su índice.
- Página alternativa con etiqueta canónica adecuada. Si aparecen muchas, tu web está generando versiones duplicadas de forma masiva.
Si alguno de los dos acumula muchas URLs, es una señal clara de que tu web produce páginas que no aportan valor.
- El ratio de páginas útiles. Es la métrica que mejor resume el problema. Calcula qué porcentaje de tus URLs indexadas ha recibido al menos una impresión en los últimos 12 meses (lo encontrarás en el informe de Rendimiento):
- Por encima del 30%: situación razonable.
- Por debajo del 30%: hay trabajo por hacer.
- Por debajo del 10%: la limpieza es urgente.
💭 Descubre más sobre esto aquí: ¿Cómo usar Screaming frog?
¿Cómo solucionarlo?
Arreglar el index bloat no consiste en desindexar páginas a lo loco. Si eliminas URLs sin revisarlas, puedes perder tráfico o enlaces que sí te estaban ayudando. Por eso, antes de aplicar cualquier solución técnica, conviene seguir un orden: primero decides qué hacer con cada URL y después eliges cómo hacerlo.
Paso 1: clasifica cada URL antes de tocar nada
Lo primero no es aplicar una solución técnica, sino decidir qué hacer con cada URL problemática. Puedes repartirlas en tres grupos:
- Valiosas: aportan a tu negocio. Se quedan y se mejoran.
- Recuperables: no merecen seguir como están, pero tienen algo que aprovechar (tráfico en el pasado, enlaces externos o potencial).
- Sobrantes: no aportan nada y pueden desaparecer.
Según el grupo en el que caiga cada URL, eliges la solución. Nunca al revés.
Paso 2: aplica la solución adecuada
- Noindex: para páginas que el usuario necesita ver, pero que no deben aparecer en Google. Por ejemplo, el buscador interno, los filtros, las etiquetas o las páginas de agradecimiento.
- Canonical: cuando varias URLs muestran el mismo contenido y quieres indicarle a Google cuál es la principal.
- Redirección 301: para páginas que eliminas, pero que tienen una sustituta clara o acumulan enlaces y tráfico.
- Consolidar: cuando varias páginas flojas hablan del mismo tema. Es mejor unirlas en una sola, porque una buena rinde más que cinco mediocres.
- Código 410: para páginas que sobran y no van a volver. Le dice a Google que se han eliminado para siempre.
Errores que pueden arruinar la limpieza
- Bloquear en robots.txt no saca las páginas de Google. Robots.txt impide que Google rastree una URL, pero si ya estaba indexada, puede seguir apareciendo.
- No combines noindex y Disallow a la vez. Si bloqueas el rastreo, Google no puede entrar a la página y nunca leerá el noindex. El orden correcto es este: primero aplicas el noindex, esperas a que Google lo procese y, solo después, si tiene sentido, bloqueas el rastreo.
- La herramienta de eliminaciones de Search Console no es una solución. Solo oculta las URLs durante unos seis meses. Sirve para urgencias, pero pasado ese tiempo vuelven a aparecer si no has corregido el problema.
Ejemplo práctico con un caso real
Una escuela de formación online llegó a nosotros con diez sitemaps y más de 10.000 URLs rastreables. De todas ellas, solo 513 estaban indexadas.
El resto eran, sobre todo, páginas sin valor, como etiquetas, una categoría de cursos duplicada, páginas de autor sin actualizar desde 2024 y bloques del maquetador que ni siquiera eran páginas.
Al revisarlo, vimos que seis de los diez sitemaps sobraban. Y no hizo falta ninguna herramienta cara, solo bastó con abrir el sitemap.xml y compararlo con el informe de indexación de Search Console.
¿Tu web tiene más URLs indexadas de las que debería?
El index bloat no suele verse a simple vista, pero afecta a tu SEO más de lo que parece. Cuando Google indexa páginas sin valor, la calidad de tu web se diluye, tus URLs compiten entre sí y las páginas importantes pierden fuerza.
La buena noticia es que tiene solución. La clave está en detectar a tiempo qué URLs sobran, decidir qué hacer con cada una y aplicar la acción técnica correcta. Eso sí, hacerlo mal puede costarte tráfico, así que conviene no improvisar.
Si has reconocido alguno de estos síntomas en tu web, en agenciaSEO.eu podemos ayudarte. Con nuestro servicio de auditoría SEO analizamos la indexación de tu sitio, identificamos qué páginas están frenando tu posicionamiento y te proponemos un plan claro para limpiar el índice sin perder lo que ya funciona.
Preguntas frecuentes
¿Cuántas páginas indexadas son demasiadas?
No hay una cifra concreta, porque depende del tamaño y del tipo de web. Una tienda online con miles de productos puede tener decenas de miles de URLs indexadas sin ningún problema. En cambio, una web corporativa con 50 páginas de servicio no debería tener 3.000. Lo importante no es el número total, sino la proporción entre las URLs indexadas y las que reciben impresiones en Google. Si menos del 30 % de tus páginas indexadas aparece alguna vez en los resultados, es probable que tengas más de las que necesitas.
¿Desindexar páginas hace bajar el tráfico?
Si las páginas que desindexas no reciben impresiones ni clics, no. No estaban aportando tráfico, así que no hay nada que perder. De hecho, al quitar ese ruido, Google puede centrarse mejor en tus páginas importantes. El riesgo aparece cuando se eliminan URLs sin revisarlas antes. Algunas pueden tener enlaces externos, tráfico residual o posicionar para búsquedas concretas. Por eso es clave clasificar primero cada URL y decidir si se mantiene, se redirige o se elimina.
¿Cuánto tarda Google en desindexar una página?
Puede ir desde unos días hasta varios meses. Google solo aplica el noindex cuando vuelve a rastrear la página, así que todo depende de la frecuencia con la que visite cada URL. Las páginas importantes y con muchos enlaces internos se rastrean a menudo y se desindexan antes. Las que están más escondidas pueden tardar semanas o incluso meses. Si tienes prisa con una URL concreta, puedes solicitar su rastreo desde la herramienta de inspección de URLs de Search Console.

